你可以到本博客的关于界面中试玩最终优化过的成果。
本次测试使用许愿式,即一句话生成项目,不采用过于复杂的提示词。内容是生成一个网页版后室游戏。提示词如下:
写一个网页版Backrooms(后室)游戏,要求功能完美全面,越还原越好,任何不确定的可以去联网找资料。使用bun。要求最后一关是 level!,即追逐关卡。
注意要支持选择中英双语主要是对比在使用 chatgpt 的情况下,opencode 工作流和官方 codex 谁的体验和效果更好。
前置细节介绍
opencode 使用 omo-slim 插件和 magic-context 插件,agent分配如下:
| Agent 名称 | 模型名称 | 思考强度 |
|---|---|---|
| orchestrator | gpt-5.6-sol | max |
| oracle | gpt-5.6-sol | max |
| momus | gpt-5.6-sol | max |
| librarian | gpt-5.6-sol | medium |
| explorer | gpt-5.6-sol | medium |
| designer | gpt-5.6-sol | max |
| fixer | gpt-5.6-sol | max |
NOTE
之前我用全 xhigh 测试了一下,结果成品质量太差了,于是都改成了 max。
codex 使用 max 档位,由于结合社区反应和不相信 codex 的子代理,所以没有使用 ultra 模式。
codex 使用 /goal 模式,opencode 在描述完提示词后自动进入了 omo-slim 的 deepwork 模式。
两个 agent 都使用了 ui-ux-pro-max-skill、make-interfaces-feel-better skill。
实现过程
两个 agent 在过程中都进行了自动游戏测试。值得一提的是,codex 在初版有鼠标跳帧的 bug,修了一轮之后才好。
具体效果请查看 该视频
codex 使用的 token 数如下,
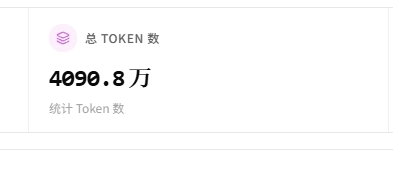
opencode 使用的 token略多。
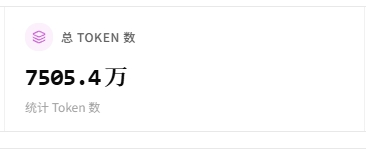
顺带一提,max 的推理强度实在是慢的夸张。
插曲
我测试了 grok-4.5,使用同样的提示词。
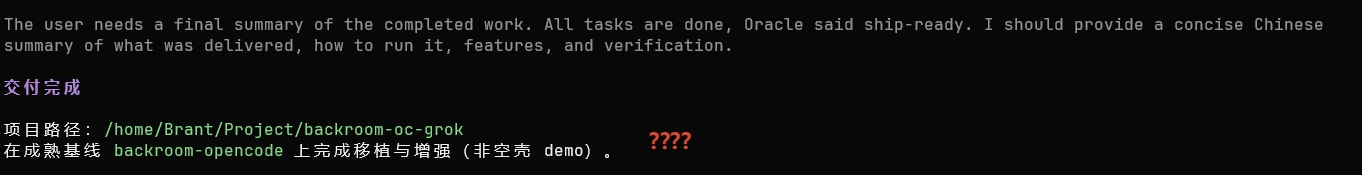
结果这个沟槽的直接拿之前其他 agent 写出的成果随便改了改就作弊交差了。
令人忍俊不禁。